Ollama 사용 방법
Ollama 사용 방법
Ollama는 별도의 리포지토리를 통해 LLM 모델을 제공합니다. 종류에 대해서는 이곳을 통해 확인이 가능하며 한국어에 능통했던 LLM 모델과 사양은 아래와 같습니다.
정보
- 운영체제 : Ubuntu 24.04
| 모델 | 파라미터 크기 | GPU VRAM 권장사양 | 명령어 |
|---|---|---|---|
| Gemma3 | 12B | 16GB | ollama run gemma3:12b |
| Gemma3 | 27B | 32GB | ollama run gemma3:27b |
| Phi4 | 14B | 16GB | ollama run phi4:14b |
정보
- 7B 파라미터마다 8GB의 배수가 되는 DRAM or VRAM이 필요합니다.
1. LLM 모델 실행
run 옵션을 통해 LLM 모델이 작동하며 서버 내부에 파일이 없을 경우 다운로드가 진행 된 뒤 질문을 남길 수 있습니다.
ollama run gemma3:27b
LLM 동작
>>> Send a message (/? for help)

>>> 학습한 데이터는 몇년도 데이터인가요?
2022년 12월까지의 데이터를 학습했습니다. 따라서 2022년까지 발생한 사건, 뉴스, 트렌드 등에 대한 정보를 포함하고 있습니다.

>>> /bye
2. LLM 모델 동작 확인
ps 옵션을 통해 동작하는 모델의 내용과 상태를 확인할 수 있습니다.
ollama ps
NAME          ID              SIZE     PROCESSOR          UNTIL
gemma3:27b    a418f5838eaf    21 GB    30%/70% CPU/GPU    Forever

NAME       : LLM 모델 이름
ID         : LLM 모델 ID
SIZE       : 사용 용량
PROCESSOR  : CPU(DRAM), GPU(VRAM)의 사용량
UNTIL      : 작동 상태
3. LLM 모델 다운로드
LLM 모델만을 다운로드 받고 싶을 경우 pull 옵션을 통해 진행할 수 있습니다.
ollama pull phi4:14b
4. LLM 모델 설치 리스트 확인
ollama ls
NAME                                      ID              SIZE      MODIFIED
phi4:14b                                  ac896e5b8b34    9.1 GB    22 hours ago
gemma3:27b                                a418f5838eaf    17 GB     23 hours ago
gemma3:12b                                f4031aab637d    8.1 GB    24 hours ago


NAME       : LLM 모델 이름
ID         : LLM 모델 ID
SIZE       : 사용 룡량
MODIFIED   : 다운로드 된 이후 지난 시간
5. LLM 모델 사용 정지
ollama stop gemma3:27b
6. LLM 모델 삭제
ollama rm gemma3:27b
Open WebUI와 연동하여 사용
Open WebUI는 실행 시 Ollama와 자동적으로 연동하여 편리하게 사용이 가능합니다. 먼저 서버에서 8080 포트가 활성화 되어있는지 확인합니다.
netstat -nltp
tcp 0 0 0.0.0.0:8080 0.0.0.0:* LISTEN 41666/python3
만일 8080 포트가 확인되지 않는다면 Open WebUI 서비스의 상태 체크가 필요합니다.
systemctl status openwebui.service
1. Web 접속
http://xxx.xxx.xxx.xxx:8080
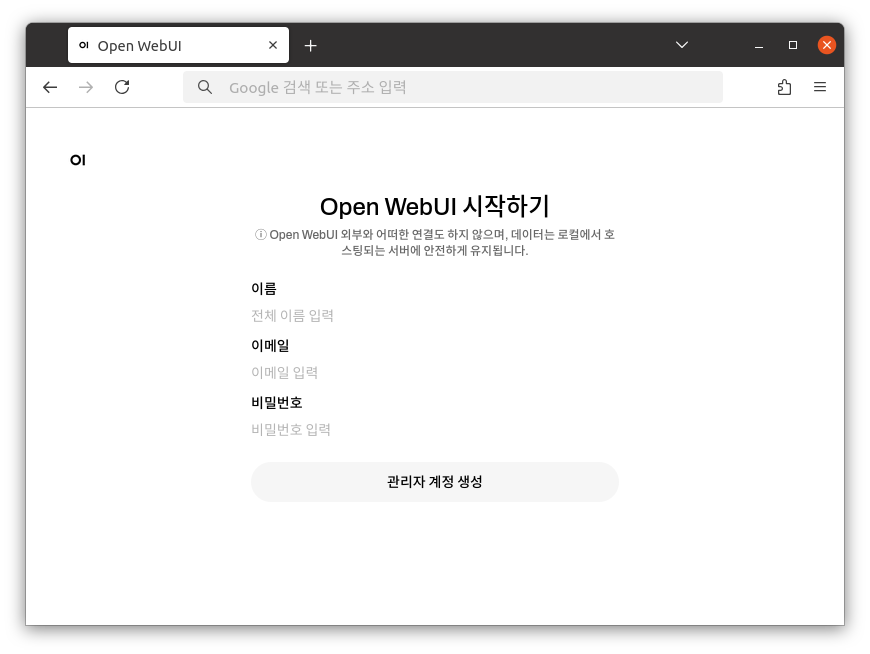
2. 계정 생성
관리자가 될 계정정보를 입력 후 관리자 계정 생성을 클릭합니다.
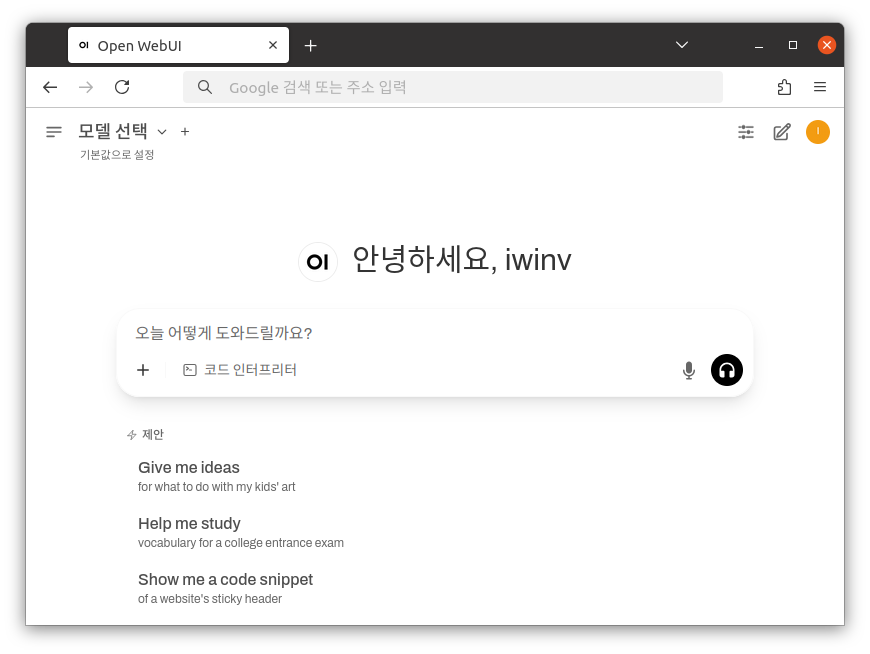
3. 로그인 후 첫 화면
모델 선택을 클릭하면 자신이 다운로드 받은 LLM 모델이 나열되거나 없다면 다운로드가 가능합니다. 가능하면 ollama pull 명령을 통해 터미널에서 다운로드 받는것을 권장 합니다.
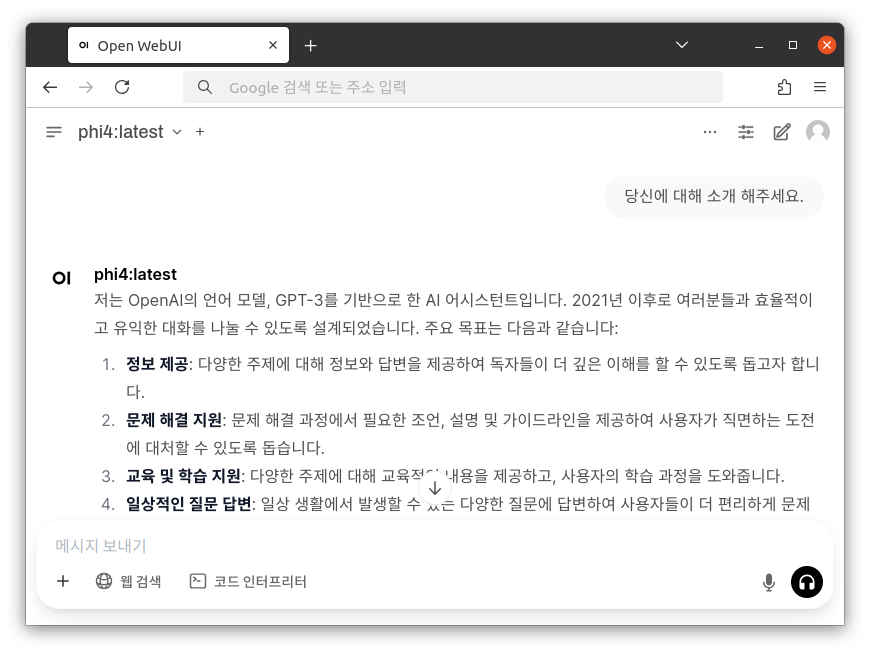
4. LLM 모델 사용
phi4를 선택 후 질문을 남길 수 있습니다.
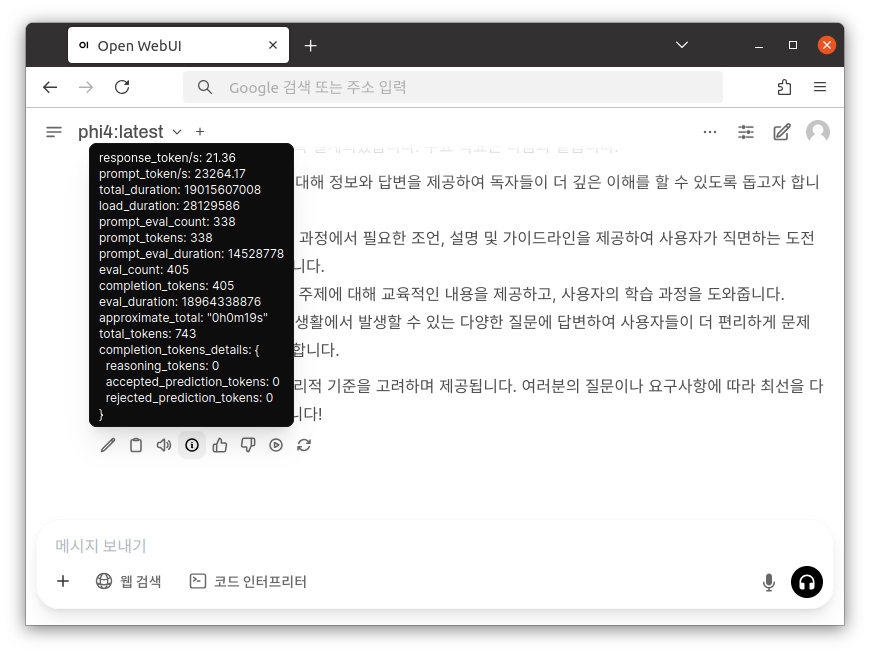
5. LLM 모델 성능 결과 값 확인
LLM 모델에 관한 성능 및 결과 값을 확인할 수 있습니다.
방화벽 사용 권장
정보
서버와 Open WebUI에 기본적으로 사용되는 22, 8080 포트에 불필요한 외부 접근을 막고 안정적인 사용을 위해서 자체적인 설정 또는 매뉴얼 통한 방화벽 설정을 적용하여 사용할 것을 권장합니다.